複数のAIエージェントがIssueを受け取り、並列で実装・QA・統合まで進められるようになると、次のボトルネックが見えてきます。
「そもそも次に何を作るのか、誰が決めるのか」という問題です。
開発速度が上がっても、Backlogの整理や優先順位付けを毎回人間が行っていれば、そこが新しい待ち時間になります。
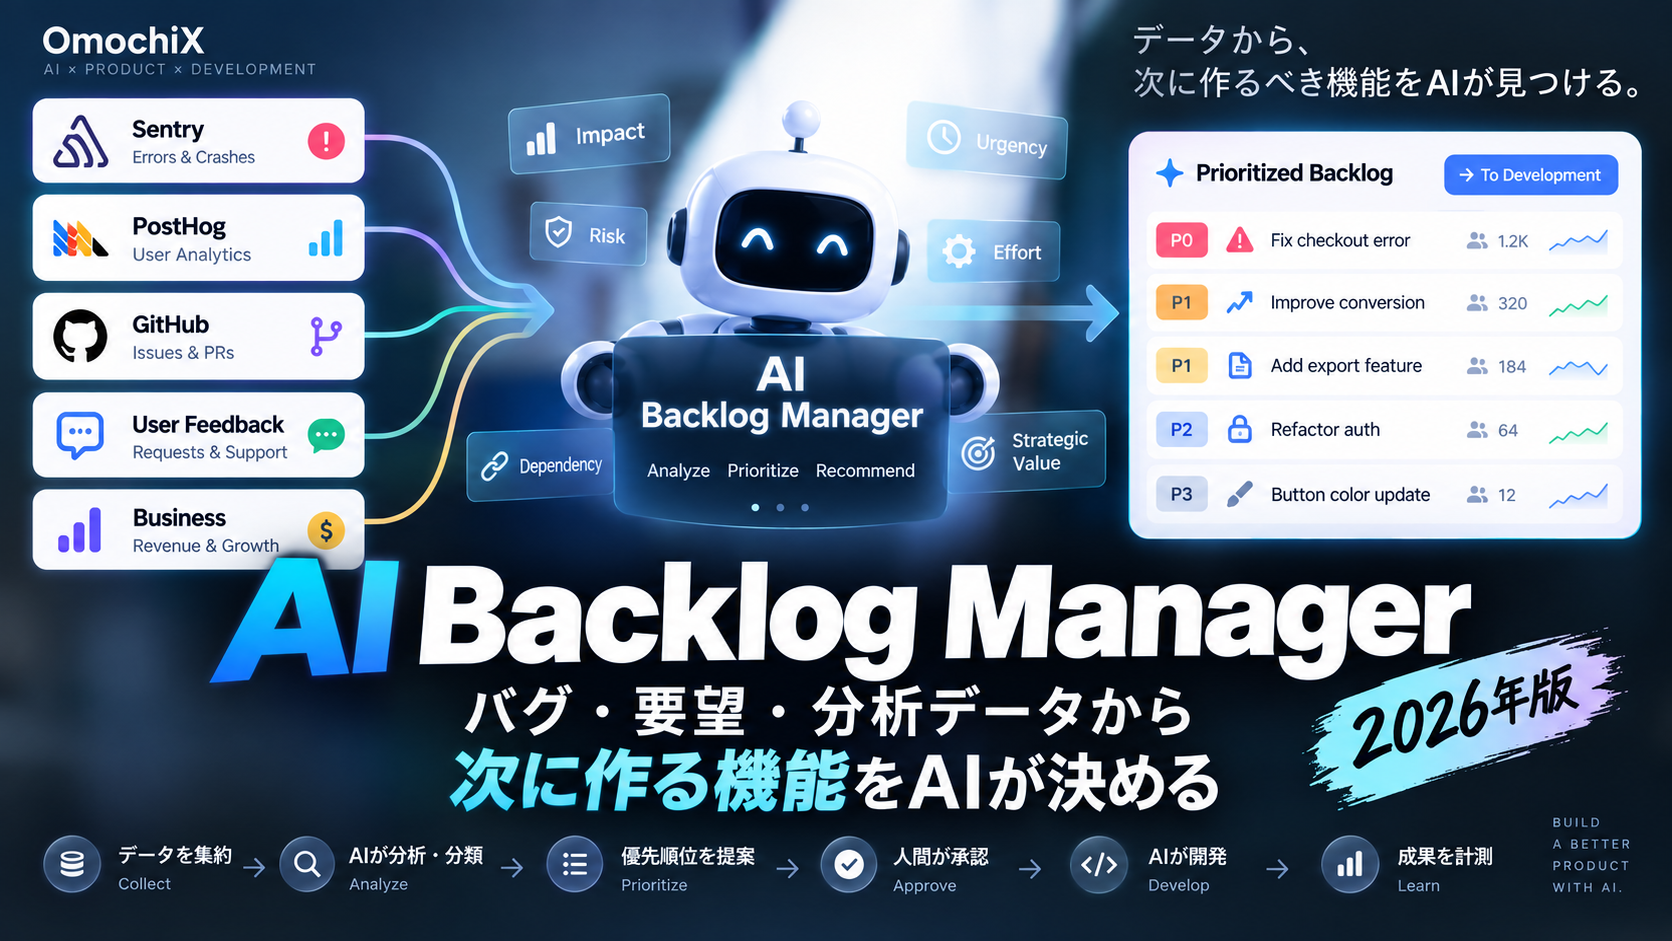
そこで今回考えるのが、Sentryの障害、PostHogの利用データ、GitHub Issue、ユーザー要望、売上への影響などを集約し、AIが優先順位を評価するAI Backlog Managerです。
重要なのは、AIへ「好きな機能を勝手に作らせる」ことではありません。
複数のデータを共通フォーマットへ整理し、Impact・Urgency・Effort・Risk・Dependencyなどを評価させ、人間が判断できる形で「次にやるべきTask」を提示させる仕組みを作ります。
この記事でわかること
- AI Backlog Managerの全体構成
- Sentry・PostHog・GitHubなどの情報をBacklogへ集約する考え方
- Impact・Urgency・Effort・Riskによる優先順位付け
- 重複Issueや依存関係をAIで整理する方法
- AI Tech LeadやClaude Codeへ開発Taskを渡す流れ
- 完全自動化せずHuman Approvalを残す設計
結論
AI Backlog Managerでは「AIにアイデアを考えさせる」のではなく、実際のユーザー行動、障害、要望、売上影響、開発コストなどを共通の判断材料へ変換し、優先順位の提案を自動化します。最初はAIが順位と根拠を提示し、人間が実行を承認する構成から始めるのが安全です。
今回作るAI Backlog Manager
最終的な流れは次のようになります。
User Feedback ──────┐
Sentry Errors ──────┤
PostHog Analytics ──┤
GitHub Issues ──────┤
Sales Requests ─────┤
Support Tickets ────┘
         ↓
Data Normalization
         ↓
Duplicate Detection
         ↓
AI Classification
         ↓
Impact / Urgency
Effort / Risk
Dependency
         ↓
Priority Score
         ↓
Human Approval
         ↓
AI Tech Lead
         ↓
Task Decomposition
         ↓
AI Development Team
         ↓
QA / Production
         ↓
Analytics / Errors
         ↓
Backlog
開発した結果から得られた新しいデータが再びBacklogへ戻るため、開発工程そのものが循環します。
これまでとの違いは「開発前」までAI化すること
これまで作ってきたAI開発ループでは、すでに作るTaskが決まっている状態から始まりました。
Human
↓
Create Issue
↓
Claude Code
↓
Implementation
↓
QA
↓
Production
AI Backlog Managerを入れると、その一つ前まで広げられます。
Product Data
↓
AI Backlog Manager
↓
Priority Recommendation
↓
Human Approval
↓
AI Tech Lead
↓
AI Development Team
↓
Production
Key Point
コードを書くAIから「何を作るべきか判断するための材料を整理するAI」へ、自動化する範囲を一段上へ広げます。
Backlogへ集めるデータ
優先順位の精度を上げるには、GitHub Issueだけを見るのではなく、異なる種類の情報をまとめて評価する必要があります。
Sentry
Productionで発生している問題です。
- Error
- Frequency
- Affected Users
- Release
PostHog
ユーザーが実際にどう使っているかを見ます。
- Events
- Funnels
- Retention
- Session Replay
GitHub
既存の開発Taskを管理します。
- Bug
- Feature
- Labels
- Dependencies
User Feedback
ユーザーが直接伝えたニーズです。
- 要望
- 不満
- 問い合わせ
- 解約理由
Business
事業への影響を加えます。
- Revenue
- Conversion
- Churn
- Strategic Value
すべてを共通フォーマットへ変換する
Sentry Errorとユーザー要望では、元データの形式がまったく違います。
そこでAIへ評価させる前に、共通のBacklog Itemへ正規化します。
Title
Type
Source
Description
Evidence
Affected Users
Frequency
Business Impact
Urgency
Estimated Effort
Risk
Dependencies
Confidence
Status
たとえばSentryのRuntime Errorなら「Bug」、フォームから届いた改善要望なら「Feature Request」と分類できます。
Evidenceを必ず残す
AIが優先順位を付けるときに重要なのが、推測と事実を混ぜないことです。
Issue:
Checkout button is difficult to find on mobile

Evidence:
- 38 user feedback reports
- Mobile checkout conversion -14%
- Session Replay shows repeated scrolling
- 72% of affected sessions are mobile

Hypothesis:
CTA visibility may be contributing to abandonment
「ボタンが悪い」と断定するのではなく、観測された事実とAIの仮説を分離します。
重要
AIの推測をEvidenceとして保存しないこと。Fact・Hypothesis・Recommendationを分けて管理すると、優先順位の根拠を後から確認できます。
重複Issueを自動でまとめる
Backlogが増えてくると、同じ問題が別の入口から何度も登録されます。
Sentry:
Checkout TypeError
        │
Support:
Payment screen broken
        │
User Feedback:
購入できない
        │
GitHub:
Checkout bug
        ↓
Duplicate Detection
        ↓
One Backlog Item
AIで意味的な類似度を判定し、同じRoot Causeの可能性が高いものをまとめます。
ただし、自動で削除するのではなく、元データへのリンクをすべて残します。
Issueを分類する
Backlog Itemは種類によって優先順位の考え方が変わります。
代表的な分類
- Bug
- Feature Request
- Performance
- Security
- UX Improvement
- Technical Debt
- Experiment
たとえばSecurityと軽微なUX改善を単純に同じScoreだけで比較するのは危険です。
Priority Scoreを作る
次に各Backlog Itemを共通の指標で評価します。
ここで使うScoreは特定サービスの公式仕様ではなく、AI Backlog Managerを作る際の設計例です。
Impact
解決したときの効果です。
- Users
- Revenue
- Conversion
Urgency
どれだけ急ぐ必要があるかです。
- Production Down
- Customer Impact
- Deadline
Effort
開発コストを推定します。
- Files
- Complexity
- Testing
Risk
変更による危険度です。
- Database
- Auth
- Billing
スコア例
たとえば1〜5で各項目を評価します。
Priority
=
(Impact × 3)
+
(Urgency × 3)
+
(Strategic Value × 2)
+
(Confidence × 1)
-
(Effort × 2)
-
(Risk × 2)
これは一例なので、自社の事業によってWeightを変えます。
3つのIssueを比較してみる
#241 Checkout Error
Impact: 5
Urgency: 5
Effort: 2
Risk: 2
Priority: HIGH

#198 Dashboard Export
Impact: 3
Urgency: 2
Effort: 3
Risk: 1
Priority: MEDIUM

#177 Button Color
Impact: 1
Urgency: 1
Effort: 1
Risk: 1
Priority: LOW
Backlogが100件あっても、毎回すべてを人間が読み比べる必要を減らせます。
売上インパクトも判断材料にする
Product Developmentでは、利用者数だけで優先順位を決められない場合があります。
影響ユーザーが少なくても、重要顧客や契約継続へ直結している機能なら優先度が高い可能性があります。
User Impact
+
Revenue Impact
+
Churn Risk
+
Conversion Impact
+
Strategic Value
↓
Business Impact
ただし「売上だけ」で決めない
数字を最適化し始めると、AIは与えられたScoreを上げる方向へ強く動きます。
そのため、Security、法令対応、データ保護、信頼性などを売上Scoreだけで低く評価しない仕組みが必要です。
Scoreだけで決めない
Security、重大障害、法令対応などは通常のPriority Scoreを上書きできるHard Gateとして扱う方が安全です。
Hard Gateを入れる
New Backlog Item
↓
Security Incident?
├── YES → P0
│
Production Down?
├── YES → P0
│
Data Loss Risk?
├── YES → P0
│
Compliance?
├── YES → Human Review
│
NO
↓
Priority Score
AIに工数を推定させる
Impactが高くても、3か月かかる機能と30分で修正できるBugでは判断が変わります。
AI Backlog ManagerはRepositoryを確認して、実装規模の概算を出すことも考えられます。
Issue
↓
Repository Analysis
↓
Related Files
↓
Architecture Impact
↓
Tests Required
↓
Migration Required?
↓
Dependency Count
↓
Estimated Effort
ただし工数はあくまでEstimateとして扱い、確定値にはしません。
ConfidenceもScoreに入れる
AIが十分なEvidenceを持っているかどうかも重要です。
High Confidence
- Analyticsあり
- 再現可能
- 複数Feedback
- Root Cause明確
Low Confidence
- 1件だけの要望
- 再現できない
- Analyticsなし
- 原因不明
Low ConfidenceなTaskは、いきなり実装せず追加調査へ回すこともできます。
実装ではなく「調査」を次Taskにする
すべてのBacklog Itemが開発Taskになるわけではありません。
Backlog Item
↓
AI Analysis
│
├── IMPLEMENT
│
├── INVESTIGATE
│
├── EXPERIMENT
│
├── WAIT
│
├── MERGE DUPLICATE
│
└── REJECT
「データが足りないのでまず計測Eventを追加する」という判断も、立派なBacklog Managementです。
依存関係もPriorityへ反映する
優先順位が高いTaskでも、前提Taskが終わっていなければ実装できません。
#201 Database Schema
↓
#202 Search API
├──────────────┐
↓              ↓
#203 Search UI  #204 Unit Tests
│              │
└──────┬───────┘
       ↓
#205 E2E
GitHub Issues側でDependencyを管理し、AIが「今実行可能なTask」だけを選ぶ構成にできます。
AI Backlog ManagerのPrompt例
Backlogを評価してください。

利用可能な情報:

- GitHub Issues
- Sentry Errors
- Product Analytics
- User Feedback
- Revenue Impact
- Repository Context
- Dependencies

各Issueについて次を評価してください。

1. Type
2. Impact
3. Urgency
4. Strategic Value
5. Estimated Effort
6. Risk
7. Confidence
8. Dependencies
9. Priority
10. Recommendation

FactとHypothesisを分けてください。

Security
Production Outage
Data Loss
Compliance
Billing
Authentication

に関わる場合は自動実装へ送らず、
Human Reviewを要求してください。

Priorityの根拠を必ず説明してください。
Priority変更の理由を残す
AIが順位を毎日変更すると、「なぜ昨日P2だったIssueが今日はP0なのか」が分からなくなります。
そのため、Scoreだけでなく理由と変更履歴を保存します。
2026-09-10
Priority: P3

Reason:
Feature request only

2026-09-14
Priority: P2

Reason:
12 additional requests detected

2026-09-15
Priority: P1

Reason:
Conversion impact confirmed
Affected users increased
GitHub IssueをBacklogの実行単位にする
優先順位が決まったTaskは、GitHub Issueへ反映できます。
GitHub APIではIssueの作成や更新、Label、Assignee、Dependencyなどを管理できます。
AI Backlog Manager
↓
GitHub Issue

Title
Description
Evidence
Priority
Risk
Dependencies
Acceptance Criteria
Recommended Tests
↓
Ready for Development
Priorityだけで自動開発を開始しない
ここが重要です。
AIがP1と判断したからといって、そのままProductionへ向けて自動開発を始める構成は初期段階ではおすすめできません。
AI Priority
↓
Recommended Next Task
↓
Human Approval
↓
READY
↓
AI Tech Lead
↓
Development
OmochiX View
「AIが優先順位を決める」とは、最初からAIに事業判断を丸投げすることではありません。AIがデータを整理し、順位と根拠を提示し、人間が最終判断するところから始めます。
承認されたIssueをAI Tech Leadへ渡す
ここから前回まで作ってきたAI開発チームへ接続します。
AI Backlog Manager
↓
Priority #1
↓
Human Approval
↓
AI Tech Lead
↓
Task Decomposition
│
├── Frontend Agent
├── Backend Agent
└── QA Agent
        ↓
Parallel Development
        ↓
Integration
        ↓
Human Review
        ↓
Production
本番データを再びBacklogへ戻す
機能を公開したら終わりではありません。
その機能が本当に改善につながったかを確認します。
Feature Released
↓
PostHog
├── Usage
├── Conversion
├── Retention
└── Session Replay

Sentry
├── Errors
└── Regressions

User Feedback
↓
Outcome Analysis
↓
AI Backlog Manager
↓
Next Improvement
これによって、開発前の仮説と公開後の結果を比較できます。
「作ったから成功」ではなくOutcomeを見る
AI開発では実装速度が速いため、機能を作った数そのものを成果にすると危険です。
Output
- PR数
- Commit数
- 実装機能数
- 開発速度
Outcome
- Conversion
- Retention
- Error Reduction
- User Satisfaction
AI Backlog Managerは「たくさん作る」ためではなく、限られた開発能力を効果の高い場所へ振り分けるための仕組みです。
PostHogの方向性とも近づいている
2026年時点のPostHogは、Product Analytics、Session Replay、Error Tracking、Feature Flags、Experimentsなどのプロダクトデータを一つの環境へ集め、AIやエージェントがProduct Contextを利用できる方向へ進んでいます。
そのため、AI Backlog Managerをゼロからすべて独自実装するだけでなく、分析基盤側に蓄積されているContextをAI開発システムへ渡す構成も考えられます。
役割を混同しない
Product Analyticsツールが持つAI機能と、この記事で設計している独自のBacklog優先順位システムは同じものではありません。既存ツールからContextを取得し、自社ルールでPriorityを評価する構成として考えます。
最初からすべて接続しない
AI Backlog Managerは段階的に作る方が安全です。
-
1
GitHub Issueだけで開始
既存IssueをAIが分類・要約・Score化します。
-
2
Sentryを追加
Production BugをBacklogへ自動で取り込みます。
-
3
Product Analyticsを追加
利用率やConversionなどのEvidenceを加えます。
-
4
Feedbackを追加
ユーザー要望を自動分類・重複統合します。
-
5
AI Priority
複数データから順位と根拠を提案します。
-
6
Development接続
承認済みTaskをAI Tech Leadへ送ります。
自動化してはいけない判断を決める
AI Backlog Managerにも停止条件が必要です。
Human判断を要求したいケース
- 事業戦略そのものを変える
- 価格変更
- 法令・Compliance
- 個人情報・Security
- 重要顧客への影響
- 大規模なArchitecture変更
- Evidenceが不足している
最終的にはAI Product Organizationへつながる
ここまでのシリーズをつなぐと、役割分担が見えてきます。
Product Data
↓
AI Backlog Manager
↓
AI Product Manager
↓
PRD / Specification
↓
AI Tech Lead
↓
Task Decomposition
↓
AI Development Team
↓
AI QA
↓
Human Approval
↓
Production
↓
Monitoring
↓
Product Data
ここまで来ると、AIは単なるCoding Toolではありません。
プロダクトが利用データを取り込み、自分自身の改善候補を作り、開発工程へ戻していくシステムに近づきます。
OmochiX View
AI開発が高速化すると、価値の中心は「どれだけ速くコードを書けるか」から「どの問題を解くべきかをどれだけ正確に選べるか」へ移っていきます。AI Backlog Managerは、その判断をデータで支援するためのレイヤーです。
3行まとめ
- Sentry・Product Analytics・GitHub Issue・User Feedbackなどを共通Backlogへ集約する
- AIがImpact・Urgency・Effort・Risk・Confidence・Dependencyを評価し、Priorityと根拠を提示する
- 承認済みTaskだけをAI Tech Leadへ渡し、開発結果を再びProduct DataとしてBacklogへ戻す
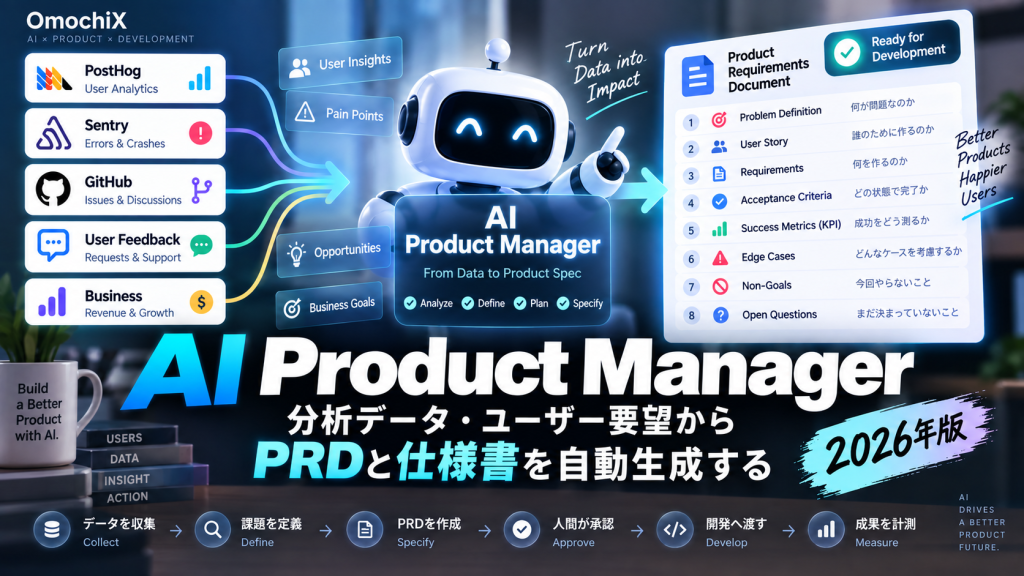
次はAI Product Managerが仕様書まで作る
AI Backlog Managerで「次に解くべき問題」が選べても、まだ一つ重要な工程が残っています。
その問題を、実装可能な仕様へ変換することです。
次の記事では、Analytics、User Feedback、既存コード、競合情報、Business Goalなどを材料に、AIがProblem Definition、User Story、Acceptance Criteria、KPI、Edge Caseまで整理してPRDを作るAI Product Managerを設計します。
あわせて読みたい
複数Claude CodeでAI開発チームを作る
Backlogから選ばれたTaskを複数のAIエージェントへ振り分け、並列実装・QA・統合まで進める設計を解説します。
あわせて読みたい
Sentry × Claude Codeで本番エラー対応を自動化
Production Errorを検知し、開発Taskとして再びAI開発フローへ戻す仕組みを解説します。
AI開発支援
開発だけでなく優先順位付けまでAI化したい方へ
Product Analytics、GitHub、Sentry、Claude Codeなどをつなぎ、Backlogから実装・QA・監視まで循環するAI開発環境を設計します。
出典:GitHub公式ドキュメント / Sentry公式ドキュメント / PostHog公式ドキュメント / Anthropic Claude Code公式ドキュメント