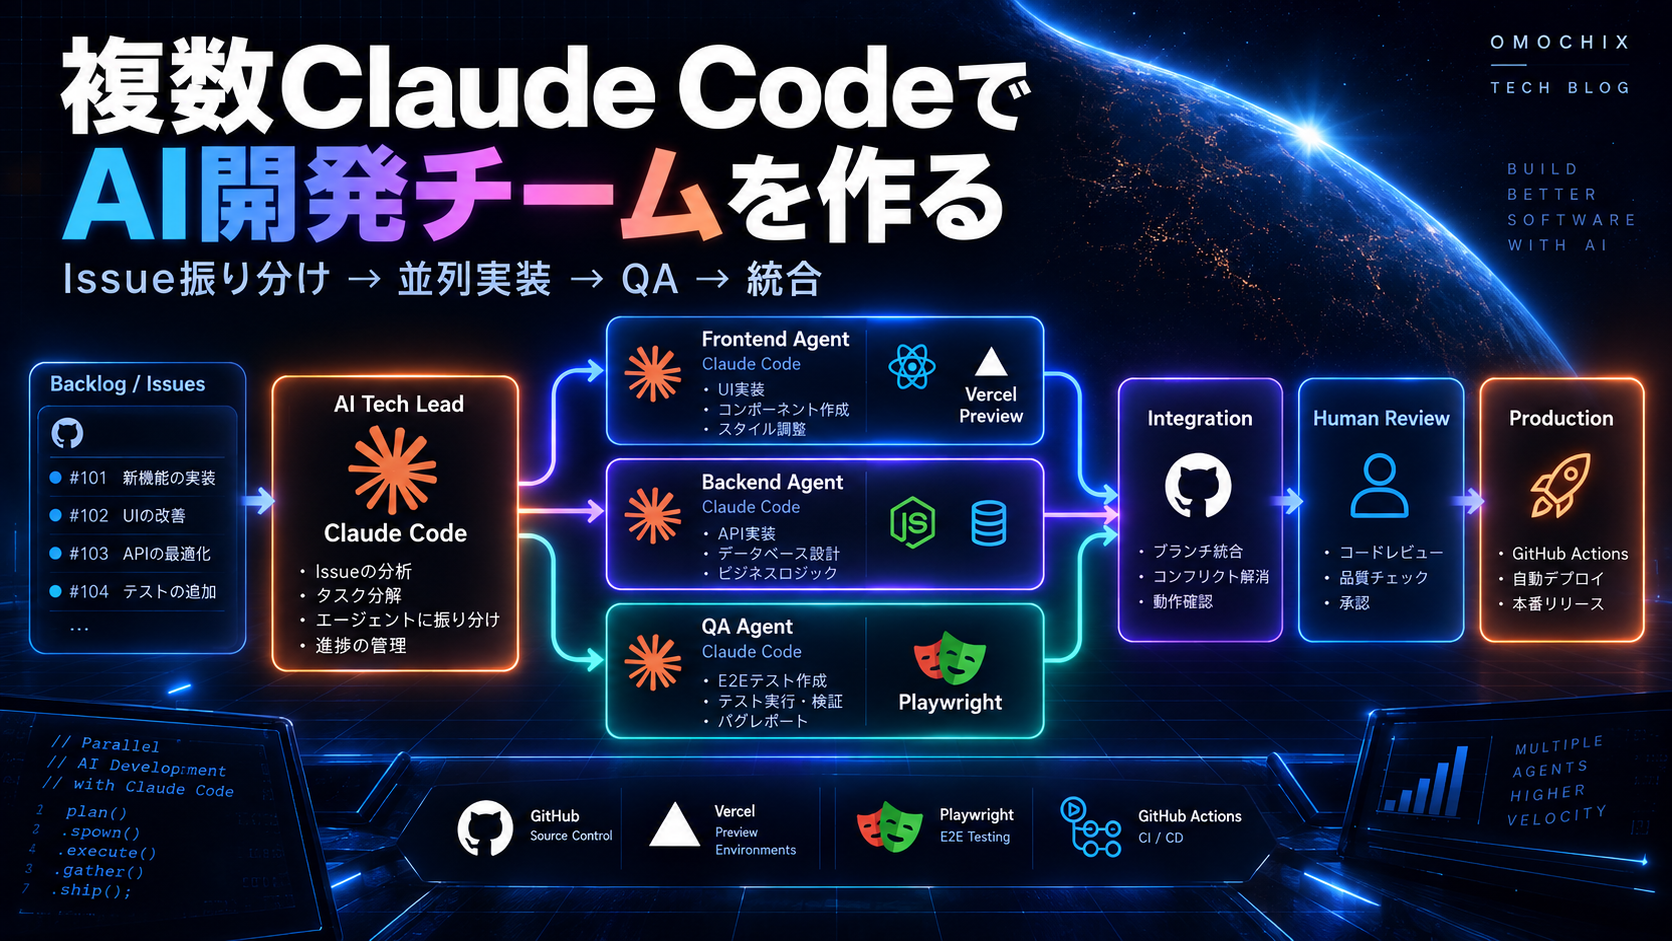
Claude Codeに一つのIssueを渡し、実装・テスト・Preview・CI・修正まで自動化できるようになると、次に考えたくなるのが「複数の開発タスクを同時に進められないか」ということです。
人間の開発チームでは、フロントエンド、API、テスト、バグ修正などを複数人へ振り分け、並列で開発を進めます。
同じ考え方は、AIコーディングエージェントにも応用できます。
Issueを分解し、それぞれを独立したClaude Codeへ割り当て、Feature Branchごとに実装し、Preview・QA・CIを通してから統合する。
これが今回考えるAI Development Teamです。
この記事でわかること
- 複数Claude Codeを並列稼働させる基本構成
- どのタスクを並列化してよいかの判断方法
- Feature BranchとWorktreeで作業を分離する考え方
- 同じファイルを複数AIが変更する競合への対策
- 各BranchのQAと統合後QAを分ける理由
- AI Tech Lead・Developer・QAへ役割分担する設計
結論
AI開発を並列化するときは、Claude Codeを何個も起動するだけでは不十分です。Issue分解、担当範囲、Branch分離、依存関係、QA、統合順序まで管理して初めて「AI開発チーム」として機能します。
今回作るAI Development Team
全体像は次のようになります。
Product Requirement
↓
Issue / Backlog
↓
Task Analysis
↓
AI Tech Lead
↓
Task Decomposition
│
├── Issue A
│   ↓
│   Claude Code A
│   ↓
│   feature/frontend
│
├── Issue B
│   ↓
│   Claude Code B
│   ↓
│   feature/api
│
└── Issue C
    ↓
    Claude Code C
    ↓
    feature/tests

        ↓ Parallel Development

Vercel Preview
↓
Branch QA
↓
GitHub Actions
↓
PASS
↓
Integration
↓
Integration QA
↓
Human Review
↓
main
↓
Production
大きな違いは、Claude Codeが一つだけではないことです。
それぞれのAIが独立したタスクとBranchを持ち、同時に作業します。
「AIを複数起動する」と「AIチーム」は違う
単純にClaude Codeを3つ起動して、同じRepositoryへ「開発して」と指示すると、問題が起きやすくなります。
並列化だけでは危険
複数AIが同じBranch、同じファイル、同じDatabase Migrationなどを同時に変更すると、競合や仕様の不一致が増え、結果的に統合作業の方が重くなる可能性があります。
AIチームとして動かすには、最低でも次の役割が必要です。
Coordinator
何を誰へ振るか決めます。
- Issue分析
- Task分解
- 依存関係
- 優先順位
Developer Agents
個別Branchで実装します。
- Frontend
- Backend
- Bug Fix
- Tests
QA
変更が正しいか検証します。
- CI
- E2E
- Regression
- Integration
最初にTaskを分解する
並列開発で最も重要なのは、AIを起動することではありません。
大きな仕様を、安全に同時実行できる単位へ分解することです。
たとえば「顧客管理画面へ検索機能を追加する」という仕様があったとします。
Customer Search Feature
│
├── A. Search API
│
├── B. Search UI
│
├── C. Validation
│
├── D. Unit Tests
│
└── E. E2E Test
一見すると5つ全部を同時に実装できそうですが、実際には依存関係があります。
Search API ──────┐
                 ├──→ Search UI
Validation ──────┘

Search API ──────→ Unit Tests

API + UI
↓
E2E Test
この場合、APIとValidationは比較的並列化しやすい一方、E2EはUIとAPIが完成してからの方が自然です。
Key Point
「タスクを小さくする」だけではなく、「どのタスクがどのタスクへ依存しているか」を明確にしてから並列化します。
並列化しやすいTask
すべての開発タスクが並列化に向いているわけではありません。
並列化しやすい例
- 別ページのUI実装
- 独立したAPI Endpoint
- Unit Test追加
- Documentation更新
- 独立したBug Fix
- 別Componentの実装
並列化しにくいTask
慎重に扱いたい例
- 同じDatabase Schemaを変更するTask
- 同じ認証処理を変更するTask
- 同じ巨大Componentを変更するTask
- 共通Interfaceを大きく変更するTask
- 同じ設定ファイルを大量に触るTask
こうした変更は順番を決めるか、一つのAgentへまとめた方が安全な場合があります。
AI Tech LeadがTaskを振り分ける
将来的には、この並列化判断そのものをAIへ任せることもできます。
最初のAIはコードを書くのではなく、Issueを分析します。
Requirement
↓
AI Tech Lead
│
├── Analyze Scope
├── Detect Dependencies
├── Detect File Overlap
├── Estimate Risk
├── Decide Parallel Tasks
└── Decide Sequential Tasks
↓
Development Plan
ここでは実装を始めず、計画だけを作らせます。
このIssueを実装可能なTaskへ分解してください。

まだコード変更はしないでください。

各Taskについて次を報告してください。

1. Task名
2. 目的
3. 主な変更予定ファイル
4. 他Taskへの依存
5. 並列実行可能か
6. Risk Level
7. 必要なTest
8. 推奨Branch名

同じファイルを複数Taskが変更する場合は明示してください。

Database Migration
Authentication
Billing
Permissions

を含む場合はHigh Riskとして扱ってください。
BranchをAgentごとに分離する
Task分解ができたら、それぞれにFeature Branchを割り当てます。
develop
│
├── feature/customer-search-api
│
├── feature/customer-search-ui
│
├── test/customer-search-unit
│
└── test/customer-search-e2e
これにより、Agent Aが失敗してもAgent Bの作業へ直接影響しにくくなります。
Git Worktreeで作業Directoryも分ける
同じマシン上で複数のClaude Codeを動かす場合、Branchだけでなく作業Directoryも分ける方法があります。
Git Worktreeを使えば、一つのRepositoryから複数Branchを別Directoryへ同時にCheckoutできます。
project/
worktrees/
├── customer-search-api/
├── customer-search-ui/
└── customer-search-tests/
各Directoryで別のClaude Codeを動かせば、同じWorking Treeを奪い合うことを防ぎやすくなります。
重要
Branchを分けても、同じローカルDirectoryを複数Agentが同時に編集すれば競合します。並列実行ではWorkspace自体の分離も重要です。
Claude Code ActionならIssue単位でも起動できる
GitHub側ではIssue、Label、AssignmentなどをきっかけにClaude Code Actionを動かす構成を作れます。
たとえばCoordinatorがTaskをIssueとして分割し、それぞれへLabelを付けます。
Parent Issue
↓
AI Coordinator
↓
Child Issues

#201 frontend
#202 backend
#203 tests
↓
Label / Assignment
↓
Claude Code Action
↓
Dedicated Branch
これにより、「人間がターミナルを3枚開く」という方法から、GitHubをTask Queueとして使う構成へ進めます。
Agentごとに担当範囲を明確にする
並列開発では、各Claude Codeへ同じような曖昧な指示を出さないことが重要です。
あなたの担当Taskは Search API のみです。

変更許可:
- app/api/customers/**
- lib/customer-search.ts
- 関連Unit Test

原則変更禁止:
- Authentication
- Database Schema
- Billing
- Frontend Components
- unrelated files

実装前に既存仕様を確認してください。

完了条件:

1. API実装
2. Validation
3. Unit Test
4. lint
5. typecheck
6. build
7. diff report

担当範囲外の変更が必要になった場合は、
勝手に変更せず停止して報告してください。
この「変更可能範囲」を明示するだけでも、複数Agent同士の衝突を減らせます。
最大の問題はFile Conflict
AI並列開発で最も起きやすい問題の一つが、同じファイルへの変更です。
Agent A
↓
app/customers/page.tsx

Agent B
↓
app/customers/page.tsx

Agent C
↓
app/customers/page.tsx

        ↓

High Conflict Risk
3つのAIがそれぞれ正しいコードを書いていても、統合すると壊れる可能性があります。
変更予定ファイルを先に予約する
そこでTask分解時点で「どのAgentがどのファイルを触る予定か」を記録します。
Agent A
- api/customers/**
- customer-search.ts
- api tests
Agent B
- CustomerSearch.tsx
- SearchFilters.tsx
- UI tests
Agent C
- E2E only
- fixtures
- QA helpers
担当範囲が重なったTaskは、順番を付けるか統合します。
File Overlapを自動判定する
さらに進めるなら、Coordinatorが変更予定ファイルの重複をチェックできます。
Task A Files
+
Task B Files
+
Task C Files
↓
Overlap Detection

NO OVERLAP
↓
Parallel

OVERLAP
↓
Dependency Analysis
↓
Sequential / Merge Tasks
共有ファイルは特別扱いする
特に競合しやすいファイルがあります。
競合しやすい場所
- package.json
- package-lock / pnpm-lock
- Prisma Schema
- Migration files
- Global Config
- Shared Types
- Authentication
このような場所はOwner Agentを決めるか、並列処理の対象外にした方が扱いやすくなります。
各BranchごとにPreviewを作る
実装が終わったら、各Feature Branchを独立して検証します。
feature/frontend
↓
Preview A

feature/api
↓
Preview B

feature/tests
↓
CI / Test Environment
Vercel PreviewのようにBranchごとの環境を持てれば、一つの共有Stagingを複数Agentが上書きし続ける状態を避けられます。
Branch QAとIntegration QAは別物
ここは非常に重要です。
各Feature Branchが単体でPASSしても、複数Branchを合わせたときにPASSするとは限りません。
Branch QA
そのAgentの変更単体を確認します。
- Lint
- Typecheck
- Build
- Focused E2E
Integration QA
複数変更を合わせて確認します。
- Full Build
- Regression
- Cross Feature E2E
- Contract Check
Key Point
「Agent AもPASS、Agent BもPASS」だけでは不十分です。A+Bを統合した状態でも必ずValidationを実行します。
Integration Branchを挟む方法
変更量が大きい場合は、mainやdevelopへすぐにMergeせず、一度Integration Branchへ集める方法もあります。
Feature A ───┐
             │
Feature B ───┼──→ integration/search-feature
             │
Feature C ───┘
                    ↓
              Vercel Preview
                    ↓
              Full Playwright
                    ↓
              Full CI
                    ↓
                 PASS
                    ↓
                develop
こうすることで、複数Agentの変更を組み合わせた状態をProduction系Branchへ入れる前に確認できます。
小さな変更ならMerge Queueも使える
一方、独立性の高いPull Requestを大量に処理する場合は、GitHubのRequired ChecksやMerge Queueを使う方法もあります。
各PRのCIがPASSしていても、先に別PRがMergeされると状態が変わります。
そのため、最新のBase Branchと組み合わせた状態で再度Checkを通してからMergeする仕組みが重要になります。
PR A ── PASS ──┐
               │
PR B ── PASS ──┼──→ Merge Gate
               │
PR C ── PASS ──┘
                    ↓
             Latest Base Branch
                    ↓
             Required Checks
                    ↓
                  PASS
                    ↓
                  Merge
依存Taskは順番を管理する
Taskが依存している場合、単純な並列処理ではなくDAGのように考えます。
Task A: Database
↓
Task B: API
├──────────────┐
↓              ↓
Task C: UI     Task D: Unit Tests
│              │
└──────┬───────┘
       ↓
Task E: E2E
Task BはAが完了するまで開始できない。
一方でCとDはBが完了した後なら同時に進められる。
この構造を持つだけで、無理な並列化を減らせます。
Agentの状態を管理する
Agentが増えてくると、「誰が今何をしているのか」を把握する必要があります。
Agent A
Task: Search API
Status: TESTING
Branch: feature/search-api
Risk: LOW

Agent B
Task: Search UI
Status: IMPLEMENTING
Branch: feature/search-ui
Risk: LOW

Agent C
Task: Migration
Status: WAITING_APPROVAL
Branch: feature/search-db
Risk: HIGH
最終的には、こうした情報をDashboard化することも考えられます。
AI DeveloperだけでなくAI QAを分ける
さらに進めるなら、コードを書いたAI自身だけにレビューさせない構成も有効です。
Developer Agent
↓
Implementation
↓
Pull Request
↓
QA Agent
↓
Independent Review
↓
Test
↓
Risk Analysis
↓
PASS / REJECT
Developer Agentは「作ること」が役割です。
QA Agentは「壊れていないことを証明すること」を役割にします。
AI Security Reviewerも追加できる
同じ仕組みを使えば、専門Agentを増やせます。
Developer
- Implementation
- Unit Test
- Bug Fix
QA
- E2E
- Regression
- Edge Cases
Security
- Auth
- Permissions
- Secrets
- Injection
最終的な役割はこうなる
Human Product Owner
↓
AI Tech Lead
│
├── AI Frontend Developer
├── AI Backend Developer
├── AI Test Engineer
├── AI Security Reviewer
└── AI Documentation Agent
        ↓
     CI / QA
        ↓
Integration
        ↓
Human Approval
        ↓
Production
ここまで来ると、AIは一人の「コーディングアシスタント」ではありません。
開発組織の複数の役割を分担する仕組みに近づいていきます。
HumanはProduct Ownerへ近づく
AIへ実装を任せる範囲が広がるほど、人間の役割も変わります。
AI Team
- Task分解
- 実装
- テスト
- レビュー
- 修正
Human
- 何を作るか
- なぜ作るか
- 優先順位
- リスク判断
- Production承認
人間がすべてのコードを書く必要は減っても、何を作るかという判断はより重要になります。
完全自律化する前に停止条件を入れる
Agentが増えるほど、自動化の暴走範囲も大きくなります。
自動進行を止めたい条件
- Database Migrationが発生する
- Auth・Permissionを変更する
- Billingへ影響する
- 複数Agentが同一ファイルを変更する
- 仕様の解釈が複数存在する
- CI修正を複数回繰り返している
- 大量のファイル変更が必要になる
OmochiX View
AIチームを強くするだけでなく、「どの条件で人間へ戻るか」をシステムとして決めることが、並列自動開発では特に重要になります。
最初は3 Agent程度から始める
理論上は多くのAgentを並列で動かせますが、最初から大量に増やす必要はありません。
-
1
1 Agent
一つのTaskを実装からQAまで回せる状態を作ります。
-
2
2〜3 Agent
独立したTaskだけを並列実行します。
-
3
Coordinator追加
Task分解と依存関係判断をAIへ任せます。
-
4
QA Agent追加
実装Agentとは別に独立検証させます。
-
5
Integration自動化
複数Branchを統合して再QAします。
AI開発速度のボトルネックが変わる
AIが一つだけなら、実装速度がボトルネックになります。
しかしAgentを並列化すると、別の問題が現れます。
1 Agent
↓
Implementation Speed

Multiple Agents
↓
Task Coordination
↓
QA
↓
Integration
↓
Human ApprovalつまりAIを増やすほど、次に重要になるのはオーケストレーションです。
目指すのはAI Software Factory
一つのIssueをAIが実装するだけなら、AI Coding Assistantの延長です。
しかしIssueが自動で分解され、複数Agentへ配分され、それぞれがBranchを持ち、PreviewとCIで検証され、統合後に再テストされるようになると、構造が変わります。
Business Requirement
↓
Backlog
↓
AI Planning
↓
Task Decomposition
↓
AI Dispatch
↓
Parallel Development
↓
Branch QA
↓
Integration
↓
Integration QA
↓
Human Approval
↓
Production
↓
Monitoring
↓
New Issues
↓
Backlog
開発工程そのものが循環し始めます。
OmochiX View
AI開発の次の競争は「どのAIが一番コードを書けるか」だけではなく、「複数のAIを安全に同時稼働させ、成果物を統合できる開発システムを誰が作れるか」に移っていく可能性があります。
3行まとめ
- 複数Claude Codeを並列稼働させるには、Task・Branch・Workspace・担当範囲を分離する
- 各BranchがPASSしても統合後に壊れる可能性があるため、Branch QAとIntegration QAの2段階で検証する
- 最終的にはAI Tech Lead・Developer・QAなどへ役割を分け、Humanは仕様・優先順位・高リスク判断へ集中する
次はAIがBacklogから「次に作るもの」を自動で選ぶ
ここまでで、Taskが決まった後の並列開発はかなり自動化できます。
しかし、まだ人間が行っている重要な作業があります。
「次に何を作るか決めること」です。
次の記事では、Bug、Feature Request、Sentry Error、Analytics、ユーザーフィードバックなどを一つのBacklogへ集約し、AIがImpact・工数・Risk・依存関係を評価して優先順位を付けるAI Backlog Managerを考えます。
あわせて読みたい
Claude CodeでAI自動開発ループを構築
並列開発へ進む前に、1つのAgentで仕様・実装・QA・本番監視まで循環させる基本構成を解説します。
あわせて読みたい
Claude CodeでCI失敗を自動修正する
各Agentが作った変更をCIで検証し、失敗原因の分析から最小修正まで自動化する方法を解説します。
AI開発支援
AI開発チーム・自動QA環境を構築したい方へ
Claude Code、GitHub、Vercel、Playwright、GitHub Actionsなどを組み合わせた並列AI開発環境の設計・導入を支援します。
出典:Anthropic Claude Code Action公式ドキュメント / GitHub公式ドキュメント / Vercel公式ドキュメント