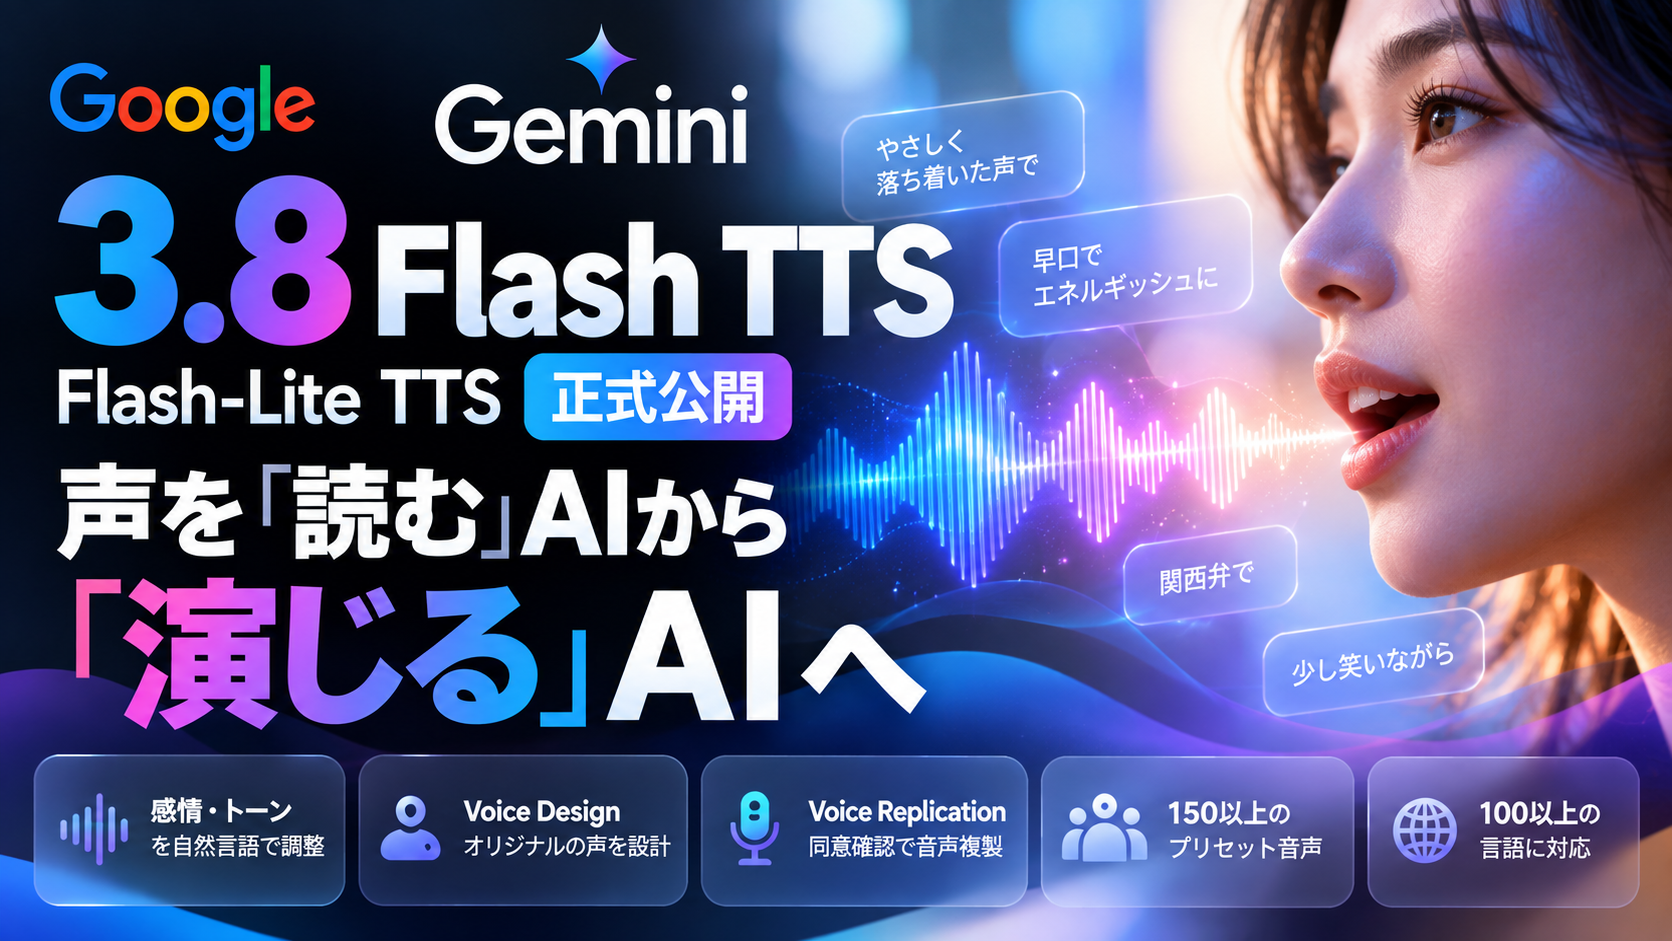
Gemini 3.8 Flash TTS正式公開。
声を「読む」AIから「演じる」AIへ
声質、感情、速度、アクセント、方言まで自然言語で指示。 Googleの新しいGemini音声モデルが、 ポッドキャスト、オーディオブック、 音声AIエージェントの制作を大きく変えます。
2つのGemini TTSモデルを正式提供
高品質な音声表現、 細かな演技、 地域ごとの方言、 長時間のマルチターン音声などを重視した フラッグシップ音声生成モデル。
高速かつ効率的な音声生成を重視。 大量コンテンツ制作、 読み上げ、 リアルタイム音声エージェントなど 高スループット用途向け。
GoogleはFlash TTSを 「スタジオ品質の音声表現」を重視するモデルとして、 Flash-Lite TTSを 高速・大量処理向けモデルとして位置づけています。
自然言語だけで声の“演技”を指示できる
Gemini TTSの大きな特徴は、 単純にテキストを音声化するだけではありません。
自然言語で 声のスタイル、感情、アクセント、速度、トーン などを指定できます。
笑い・ため息・咳まで音声演出に組み込める
Gemini TTSでは、 通常の文章だけでなく、 音声中の細かな出来事を 指定することもできます。
たとえば、 笑い声、ため息、咳、 呼吸、短い間など、 会話に含まれる細かな音声表現を 音声へ組み込めます。
Voice Designで「存在しない声」を作れる
新モデルでは Voice Design にも対応しています。
用意された声を選ぶだけではなく、 自然言語で声の人物像を指定し、 オリジナルの音声キャラクターを 作成できます。
たとえば、
という使い方が可能になります。
Voice Replicationにも対応
Gemini 3.8 TTSでは、 既存の声を再現する Voice Replication にも対応します。
150以上の音声を使えるVoice Library
Googleは新しい Extended Voice Library も提供します。
APIのVoicesエンドポイントから、 150以上のプリセット音声や ユーザーが作成したカスタム音声を 検索・利用できます。
これにより、 用途ごとに毎回声を作り直すのではなく、 ブランド用ナレーター、 キャラクター、 社内音声アシスタントなどを 継続して利用しやすくなります。
100以上の言語に対応、日本語も対象
Gemini 3.8 Flash-Lite TTSは、 入力言語を自動判定し、 100以上の言語に対応しています。
Googleの公式ドキュメントには 日本語 も対応言語として掲載されています。
多言語展開する動画、 オーディオブック、 教育コンテンツ、 グローバルな音声サービスなどでも 利用しやすい構成です。
Googleの各サービスへ広がる
Googleによると、 新しいGemini TTSは以下の環境で利用できます。
音声AIエージェントにも大きな影響
Flash-Lite TTSは、 大量の音声生成だけでなく リアルタイム音声エージェント を意識したモデルです。
AIエージェントが会話内容を考え、 TTSモデルが人間らしい声として出力することで、 電話対応、 カスタマーサポート、 ナビゲーション、 教育AIなどへ利用できます。
OmochiX視点:声はAIの「UI」になっていく
AIの進化はこれまで、 テキスト回答の精度を中心に語られてきました。
しかし音声モデルが進化すると、 ユーザーがAIを操作する方法そのものが変わります。
Voice Designによって AIごとに固有の声を持たせ、 感情や話し方まで設計できれば、 声そのものがAIサービスのUIやブランドになる 可能性があります。
特に音声エージェントでは、 「何を答えるか」だけでなく 「どう話すか」 が体験品質を大きく左右します。
AI動画、AIキャラクター、 電話対応AI、バーチャルアシスタントなど、 生成AIの次の競争領域では 音声の重要性がさらに高まりそうです。
まとめ
Googleは Gemini 3.8 Flash TTSと Gemini 3.8 Flash-Lite TTSを 正式公開しました。
新モデルでは、 感情、速度、トーン、方言などを 自然言語で制御できるほか、 Voice Design、 同意確認付きVoice Replication、 150以上の音声ライブラリにも対応します。
Flash-Liteは 大量生成や音声AIエージェントなど、 速度と効率を重視する用途にも向いています。
AI音声は単なる 「文章読み上げ」から、 キャラクターやブランドを持ち、 人間と自然に会話するインターフェース へ進み始めています。
あわせて読みたい
一次情報
Gemini API公式リリースノート・2026年9月22日
Gemini APIリリースノートを見る →
音声生成、話者設定、スタイル制御、対応言語などの 開発者向け公式ドキュメント。
Gemini TTSドキュメントを見る →