AIとの会話が、「質問して答えてもらう」だけではなくなろうとしています。
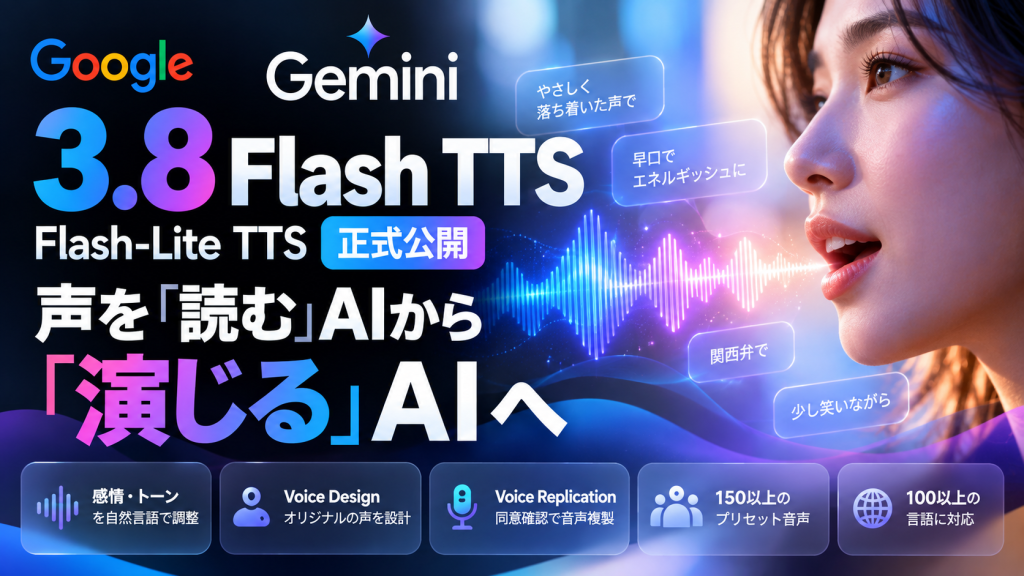
Googleは2026年9月15日、新しいリアルタイムAIモデル「Gemini 3.8 Live」と、より複雑な推論を行う「Gemini 3.8 Live Extended Thinking」を発表しました。
今回の発表で重要なのは、単純に音声が自然になったことではありません。
人間と会話を続けながらAIが考え、必要なツールを使い、複数ステップの仕事を進める。
つまり、音声AIが「話せるチャットボット」から「会話しながら仕事をするAIエージェント」へ近づいています。
この記事でわかること
- Gemini 3.8 Liveとは何か
- Extended Thinkingは通常版と何が違うのか
- 「会話しながら考えるAI」がなぜ重要なのか
- Gemini APIで何が作れるようになるのか
- 音声AIとAIエージェントが融合すると何が変わるのか
- 将来「アプリを操作する」という行為が減る可能性
最初に結論
今回のGemini 3.8 Liveで注目すべきなのは音声認識そのものではありません。「音声 × 推論 × ツール実行 × AIエージェント」が一つにつながり始めていることです。将来的には、人間がアプリを一つずつ操作するのではなく、AIへ目的を話すだけで仕事が進む世界につながる可能性があります。
Googleが「Gemini 3.8 Live」を発表
Googleは2026年9月15日、Geminiシリーズの新しいリアルタイムAIモデルを発表しました。
今回登場したのは、大きく2つです。
Gemini 3.8 Live
リアルタイムでの自然な音声・マルチモーダル対話を重視したモデル。
- リアルタイム音声
- マルチモーダル
- 低遅延対話
Extended Thinking
より複雑なタスクやマルチステップ推論を想定したLiveモデル。
- 高度な推論
- ツール利用
- 複数ステップ処理
これまでの音声AIと何が違う?
音声AI自体は新しいものではありません。
SiriやAlexaなど、私たちは以前からAIへ話しかけて操作する体験をしてきました。
最近では生成AIによって、より自然な会話も可能になっています。
しかし、多くの音声AIは基本的に、
人間が質問
↓
AIが理解
↓
AIが回答
↓
次の質問を待つ
という構造でした。
ところがAIエージェントでは、ここに「実際に仕事を進める」という要素が入ります。
Gemini 3.8 Liveが目指す「会話しながら考えるAI」
今回特に注目したいのが、Gemini 3.8 Live Extended Thinkingです。
複雑なタスクでは、AIがすぐに回答するだけでは不十分です。
状況を理解し、必要な情報を調べ、場合によっては外部ツールを利用し、その結果を踏まえて次の処理を考える必要があります。
-
1
人間が目的を伝える
細かい操作方法ではなく、「何をしたいのか」をAIへ話します。
-
2
AIが考える
目的を達成するために必要な情報や手順を推論します。
-
3
必要なツールを使う
検索や外部サービスなど、接続されたツールを必要に応じて利用します。
-
4
会話を続ける
人間とコミュニケーションしながら条件や目的を調整します。
-
5
仕事を進める
AIが単に答えるだけではなく、目的達成までの処理を進めます。
重要
音声が単なる「文字入力の代わり」ではなく、AIエージェントへ仕事を依頼するためのインターフェースになり始めています。
たとえば「北海道旅行を予約して」と話したら?
分かりやすい例として旅行を考えてみましょう。
ユーザーがAIへ、
「来週末、東京から北海道へ2泊3日で行きたい。予算10万円くらいで調べて」
と話したとします。
従来のAIなら、北海道旅行についておすすめの場所や一般的な情報を回答するところまでが中心でした。
しかしAIエージェントなら、さらに先へ進めます。
「北海道へ行きたい」
↓
日程・予算を理解
↓
航空券を検索
↓
ホテルを検索
↓
料金・場所を比較
↓
旅程を作成
↓
人間へ確認
↓
次の処理へ
さらに予約サービスまで接続されれば、ユーザーの承認を得たうえで実際の予約処理まで進めるAIも考えられます。
ここまで来ると、AIは「質問に答えるサービス」というより、仕事を依頼する相手に近くなります。
Gemini APIから開発者も利用できる
今回の発表が重要なのは、Google自身のGeminiアプリだけで完結する技術ではないことです。
GoogleはGemini APIやGoogle AI Studioを通じて、開発者がLiveモデルを利用できる環境を提供しています。
つまり企業や個人開発者も、自分たちのサービスへリアルタイムAIを組み込めます。
考えられるサービス
- 24時間対応するAIカスタマーサポート
- 電話や店舗で対応するAI受付
- 営業担当を支援するAI営業アシスタント
- 予定やタスクを管理するAI秘書
- 音声で操作できるCRM・業務システム
- 予約・問い合わせを処理するAIエージェント
- 音声で開発を進めるコーディングエージェント
「AIモデルの性能競争」から「AIが何をしてくれるか」の競争へ
ここ数年、生成AIではモデル性能そのものが大きな注目を集めてきました。
どのモデルがベンチマークで強いのか。
どのモデルが数学やコーディングで優れているのか。
どのモデルが最も高性能なのか。
もちろん、これらは今後も重要です。
しかしAIの能力が高くなるにつれて、別の競争が始まっています。
次の競争軸
「AIがどれだけ賢いか」から「そのAIが現実世界で何をしてくれるのか」へ。モデル単体の性能だけではなく、音声、推論、検索、ツール利用、外部サービス、記憶などを組み合わせたAIエージェント全体の体験が重要になっていきます。
スマホの次のインターフェースは「AIとの会話」になる?
さらに長期的に見ると、今回の技術はスマートフォンやPCの使い方そのものを変える可能性があります。
現在、私たちが何かをしたい場合は、基本的に自分でアプリを操作します。
やりたいことを考える
↓
スマホを開く
↓
アプリを探す
↓
メニューを探す
↓
文字を入力
↓
ボタンを押す
↓
別アプリへ移動
しかしAIエージェントが十分に進化すると、この構造が変わる可能性があります。
たとえば、
「明日の予定を整理して」
「取引先から来たメールを確認して、返信案を作って」
「今月の売上を見て、問題があるところを教えて」
「来週の出張を調べて」
「今日やるべき仕事を優先順位順に並べて」
こうした目的をAIへ話すだけで、必要なアプリやサービスをAI側が利用する世界です。
人間が「アプリ」を操作しなくなる可能性
もしこの方向へ進めば、ソフトウェアの役割そのものも変わります。
現在は人間がSaaSやアプリのUIを操作しています。
しかし将来は、
人間
↓
AIへ目的を伝える
↓
AIエージェント
↓
メール / カレンダー / CRM / 検索 / SaaS / API
↓
AIが結果をまとめる
↓
人間が確認・承認
という構造が増える可能性があります。
つまりAIが、人間とソフトウェアの間に入る「新しい操作レイヤー」になるということです。
ここがポイント
AIエージェント時代には「人間が使いやすいUI」だけではなく、「AIが安全かつ正確に操作できるAPIや権限設計」がソフトウェア側でも重要になる可能性があります。
音声AIが普及すると「AI秘書」が現実になる
音声AIとAIエージェントの組み合わせで特に分かりやすいのが、AI秘書です。
現在のAI秘書は、文章作成や予定整理など一部の仕事を支援するものが中心です。
しかしリアルタイム音声、推論、ツール実行が組み合わされれば、より人間の秘書に近い動きが可能になります。
-
1
話しかける
「今日の予定教えて」のように自然な言葉で指示。
-
2
状況を理解
予定、メール、タスクなど利用を許可された情報を確認。
-
3
仕事を提案
優先順位や必要な対応を整理して提案。
-
4
承認後に実行
必要に応じて人間の確認を取りながら処理を進める。
ただし「AIが何でも勝手にできる」わけではない
ここは重要な注意点です。
AIエージェントが高度になったからといって、すぐにあらゆるアプリやサービスを自由に操作できるわけではありません。
実際には、API接続、サービス側の対応、ユーザー認証、権限設定、セキュリティ、確認フローなどが必要です。
注意
「音声で指示すればAIが何でも自動実行できる」という段階ではありません。特にメール送信、購入、予約、決済、データ削除など重要な操作では、人間による確認や適切な権限管理が不可欠です。
OmochiX視点|「声」はAI時代のマウスになるかもしれない
今回のGemini 3.8 Liveを、単なるGoogleの新モデルとして見ると本質を見落とします。
OmochiXが注目しているのは、AIとの接点そのものが変わろうとしていることです。
PCではマウスとキーボード。
スマートフォンではタッチパネル。
そしてAI時代には、そこへ「自然言語」が加わります。
その中でも声は、人間にとって非常に自然な入力方法です。
しかも、その先にいるAIが「質問へ答えるだけ」ではなく、推論し、ツールを使い、実際の仕事を進められるようになれば、音声インターフェースの意味は大きく変わります。
この記事の結論
Gemini 3.8 Liveで重要なのは「AIともっと自然に話せる」ことだけではありません。話す → AIが理解する → 考える → ツールを使う → 仕事を進めるという一連の流れがつながり始めていることです。AIが人間とソフトウェアの間に入るようになれば、将来的には「アプリを操作する」という現在当たり前の行動そのものが変わる可能性があります。
3行まとめ
- GoogleがリアルタイムAI「Gemini 3.8 Live」と、複雑な推論を想定した「Gemini 3.8 Live Extended Thinking」を発表
- 重要なのは音声だけでなく、推論・ツール利用・AIエージェントが組み合わさり始めていること
- 将来的には人間がアプリを直接操作するのではなく、AIへ目的を話して仕事を進める体験が広がる可能性がある
OmochiXで学ぶ
AIエージェントとは?
チャットAIとの違いから、ツール利用・自律実行の仕組みまで、AIエージェントの基本を初心者向けに解説します。
主な出典:Google公式「Gemini 3.8 Live / Gemini 3.8 Live Extended Thinking」関連発表・Gemini API関連資料。本記事は2026年9月16日時点で公開されている情報をもとに作成しています。実際に利用できるモデル・機能・提供地域・API仕様などは今後変更される可能性があります。